RailsでDB定義書を自動生成
mmmuser
デロイト トーマツ ウェブサービス株式会社(DWS)公式ブログ
こんにちは、ino です。
最近、業務の中で API のパフォーマンス改善に取り組む機会がありました。
調べていくと、遅さの原因は DB に発行しているクエリにあることが多く、その内容もインデックスが使われていない、不要な処理をしているなど、よくあるパターンに当てはまるものでした。
こうしたパターンは、あらかじめ知っておくと、実行計画のどこに注目すればよいかも見当がつきやすくなります。
この記事では、遅いクエリのよくあるパターンをサンプル環境で再現し、EXPLAIN ANALYZE(クエリを実際に実行して、処理ごとの時間や行数を表示する機能)で原因を確認して改善するまでを紹介します。
DB のパフォーマンスを改善する方法はさまざまです。インスタンスのスケールアップやリードレプリカの追加、DB 設定の調整、SQL やインデックス、アプリケーションからのクエリの発行方法を見直すなどあります。
インフラの変更は、コードを変えずに効果が出る手軽さがあります。一方で、遅さの原因がクエリ自体にある場合は、スケールアップで一時的に速くなっても、データ量が増えれば再び遅くなる可能性があります。
そのため、クエリに問題がないかも合わせて確認しておくことが重要だと思います。
この記事で扱うのは、このクエリの改善(クエリチューニング)についてです。
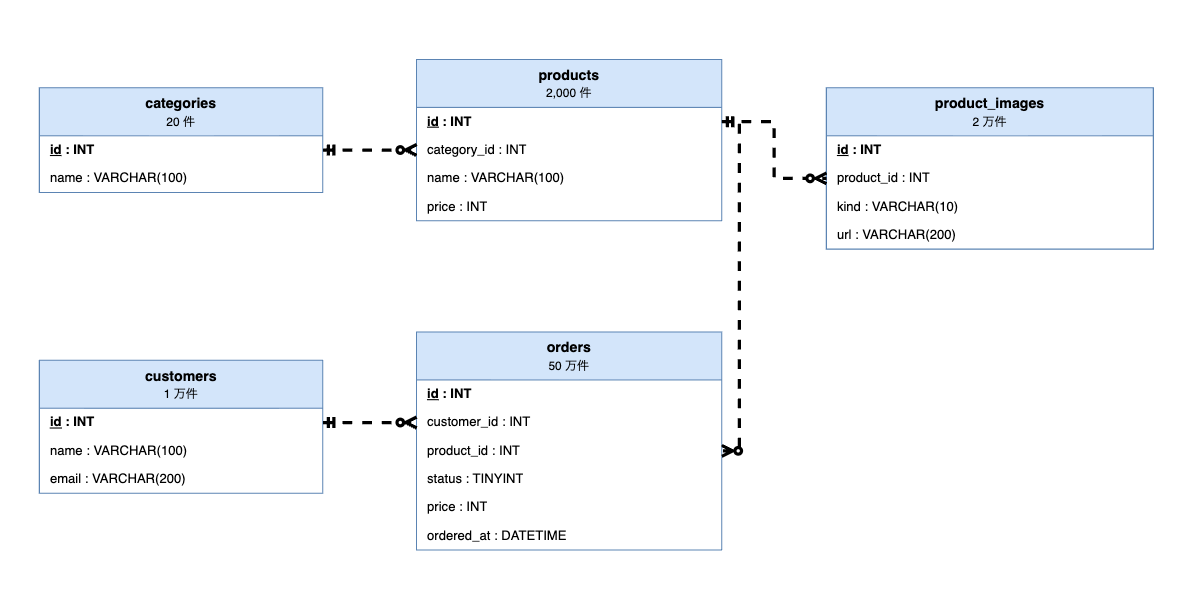
以下のようなシンプルなスキーマで、カテゴリ(categories、20 件)、顧客(customers、1 万件)、商品(products、2,000 件)、商品画像(product_images、2 万件)、注文(orders、50 万件)の 5 つのテーブルを用意します。
CREATE TABLE categories (
  id   INT PRIMARY KEY,
  name VARCHAR(100) NOT NULL
);

CREATE TABLE customers (
  id    INT PRIMARY KEY,
  name  VARCHAR(100) NOT NULL,
  email VARCHAR(200) NOT NULL
);

CREATE TABLE products (
  id          INT PRIMARY KEY,
  category_id INT NOT NULL,
  name        VARCHAR(100) NOT NULL,
  price       INT NOT NULL
);

CREATE TABLE product_images (
  id         INT PRIMARY KEY,
  product_id INT NOT NULL,
  kind       VARCHAR(10) NOT NULL,
  url        VARCHAR(200) NOT NULL,
  INDEX idx_product_images_product_id (product_id) -- product_idにインデックスを作成
);

CREATE TABLE orders (
  id          INT PRIMARY KEY,
  customer_id INT NOT NULL,
  product_id  INT NOT NULL,
  status      TINYINT NOT NULL,
  price       INT NOT NULL,
  ordered_at  DATETIME NOT NULL
);
後でインデックスの有無による違いを確認するため、外部キー制約は設定していません。
なお、以降の実行計画はすべて MySQL の出力です。記事中の実行時間は手元のPC上で計測したもので、環境によって異なります。
EXPLAIN ANALYZE は、PostgreSQL や MySQL(8.0.18 以降)などで使える機能です。
通常の EXPLAIN がオプティマイザの見積もりだけを表示するのに対し、EXPLAIN ANALYZE は実際にクエリを実行し、各処理にかかった時間と行数を表示します。
実際に実行するため、重いクエリや本番環境での実行には注意が必要です。
出力はツリー形式で、インデントが深いものが子の処理です。子の処理が返した行を、上の階層の親の処理が受け取ります。Nested loop のように子が 2 つある場合、下側の処理は、上側の処理が返した行ごとに繰り返し実行されます。各行の末尾にある括弧のうち、cost と rows を含む前半が見積もり、actual time から始まる後半が実測値です。
-> Nested loop inner join  (cost=216925 rows=481289) (actual time=0.396..312 rows=500000 loops=1)
    -> Table scan on o  (cost=48474 rows=481289) (actual time=0.393..41.4 rows=500000 loops=1)
    -> Single-row index lookup on p using PRIMARY (id=o.product_id)  (cost=0.25 rows=1) (actual time=422e-6..441e-6 rows=1 loops=500000)
MySQL の公式ドキュメントによると、actual time は「最初の1行を返すまでの時間..すべての行を返すまでの時間」をミリ秒で表したもので、子の処理の時間も含みます。rows はその処理が返した行数、loops はその処理が実行された回数です。また、loops が 2 以上の場合、actual time と rows はどちらも 1 回あたりの平均値になります。そのため、処理全体の合計は、時間や行数に loops を掛けたものに相当します。
上の例の Single-row index lookup は、1回あたり 441e-6 ≒ 0.0004 ミリ秒ほどで一見とても速いです。一方で loops は 500000 なので、この処理は 50 万回実行されています。1回あたりの時間に回数を掛けると、合計では約 221 ミリ秒になります。実行計画を見るときは、actual time だけでなく、loops や rows が極端に大きい処理がないかを探すと、ボトルネックの目安になると思います。
参考:
いくつか典型的なパターンとその改善について紹介します。
カテゴリを指定して商品ごとの注文数と売上を集計するクエリを例にします。
SELECT p.id, p.name, COUNT(*) AS order_count, SUM(o.price) AS sales
FROM products p
INNER JOIN orders o ON o.product_id = p.id
WHERE p.category_id = 3
GROUP BY p.id, p.name;
EXPLAIN ANALYZE の結果は次のとおりです。
-> Table scan on <temporary>  (actual time=421..421 rows=100 loops=1)
    -> Aggregate using temporary table  (actual time=421..421 rows=100 loops=1)
        -> Nested loop inner join  (cost=224951 rows=49913) (actual time=1.23..407 rows=25000 loops=1)
            -> Table scan on o  (cost=50257 rows=499125) (actual time=0.879..61.3 rows=500000 loops=1)
            -> Filter: (p.category_id = 3)  (cost=0.25 rows=0.1) (actual time=614e-6..617e-6 rows=0.05 loops=500000)
                -> Single-row index lookup on p using PRIMARY (id=o.product_id)  (cost=0.25 rows=1) (actual time=478e-6..498e-6 rows=1 loops=500000)
全体で約 421 ミリ秒かかっています。Table scan on o は orders の全件走査を意味し、50 万行すべてを読んでいます。そのうえで、読んだ1行ごとに products を主キーで引き、category_id = 3 かどうかを確かめています(loops=500000)。結果として残るのは 25000 行で、9 割以上の行を読んでは捨てていることになります。
本来は、行数の少ない products をカテゴリで先に絞り込み、該当する商品の注文だけを orders から取り出せば済むはずです。そうならないのは、orders.product_id にインデックスがなく、商品 ID から注文を効率よく引けないためです。そこで、結合キーにインデックスを作成します。
CREATE INDEX idx_orders_product_id ON orders (product_id);EXPLAIN ANALYZE の結果は次のとおりです。
-> Table scan on <temporary>  (actual time=46.4..46.4 rows=100 loops=1)
    -> Aggregate using temporary table  (actual time=46.4..46.4 rows=100 loops=1)
        -> Nested loop inner join  (cost=17706 rows=50013) (actual time=0.442..38.8 rows=25000 loops=1)
            -> Filter: (p.category_id = 3)  (cost=202 rows=200) (actual time=0.0461..0.486 rows=100 loops=1)
                -> Table scan on p  (cost=202 rows=2000) (actual time=0.0442..0.38 rows=2000 loops=1)
            -> Index lookup on o using idx_orders_product_id (product_id=p.id)  (cost=62.6 rows=250) (actual time=0.335..0.372 rows=250 loops=100)
結合の順番が入れ替わり、先に products を 100 件に絞り込んでから、作成したインデックスで orders を引くようになりました。orders の50万行全件走査がなくなり、改善後は orders のインデックス検索を100回行うだけで済んでいます。全体の時間は約 421 ミリ秒から約 46 ミリ秒と、9 倍ほど速くなっています。
外部キー制約を付けた場合、MySQL では参照する側の列(今回の orders.product_id のような列)にインデックスが自動で作られますが、PostgreSQL では自動では作られません。
外部キー制約の有無やDBの種類によってインデックスの扱いが異なるため、結合に使う列のインデックスが漏れていないかを確認することが重要です。
特定の日の注文を集計するクエリを例にします。
注文日時の列 ordered_at に、事前にインデックスを作成します。
CREATE INDEX idx_orders_ordered_at ON orders (ordered_at);

SELECT COUNT(*), SUM(price)
FROM orders
WHERE DATE(ordered_at) = '2025-06-01';
EXPLAIN ANALYZE の結果は次のとおりです。
-> Aggregate: count(0), sum(orders.price)  (cost=100170 rows=1) (actual time=65.8..65.8 rows=1 loops=1)
    -> Filter: (cast(orders.ordered_at as date) = '2025-06-01')  (cost=50257 rows=499125) (actual time=0.302..65.8 rows=687 loops=1)
-> Table scan on orders (cost=50257 rows=499125) (actual time=0.269..43.6 rows=500000 loops=1)インデックスがあるにもかかわらず、Table scan on orders で 50 万行を全件走査し、該当する 687 行を探しています。
原因は、WHERE 句で ordered_at を DATE 関数で加工していることです。インデックスは ordered_at の値そのものの順に並んでいるため、「DATE 関数を通した結果が 2025-06-01 になる行」を、インデックスから直接探すことはできません。結果として、全行に関数を適用して確かめるしかなくなります。
対処としては、列を加工せず、範囲の条件に書き換えます。
SELECT COUNT(*), SUM(price)
FROM orders
WHERE ordered_at >= '2025-06-01' AND ordered_at < '2025-06-02';
EXPLAIN ANALYZE の結果は次のとおりです。
-> Aggregate: count(0), sum(orders.price)  (cost=378 rows=1) (actual time=1.09..1.09 rows=1 loops=1)
    -> Index range scan on orders using idx_orders_ordered_at over ('2025-06-01 00:00:00' <= ordered_at < '2025-06-02 00:00:00'), with index condition: ((orders.ordered_at >= TIMESTAMP'2025-06-01 00:00:00') and (orders.ordered_at < TIMESTAMP'2025-06-02 00:00:00'))  (cost=309 rows=687) (actual time=0.375..1.05 rows=687 loops=1)
Index range scan となり、インデックスで必要な範囲だけを読むようになりました。約 66 ミリ秒から約 1 ミリ秒に短縮されています。
クエリを書き換えられない場合は、関数インデックス(式の結果に対して作るインデックス)を使う方法もあります。
CREATE INDEX idx_orders_ordered_date ON orders ((CAST(ordered_at AS DATE)));MySQL では DATE(ordered_at) が内部的に CAST(ordered_at AS DATE) として扱われます。そのため、上記の式で作成したインデックスが使われます。実行計画には Index lookup on orders using idx_orders_ordered_date と表示され、元の DATE(ordered_at) = '2025-06-01' のままでもインデックスが使われることを確認できました。
ただし、関数インデックスは式が一致しないと使われないため、その点は注意です。
期間内の注文の総件数を取得するクエリです。商品名、顧客名などを表示する一覧用のクエリに対して、件数の取得のためにそのまま COUNT(*) で SELECT した例になります。
SELECT COUNT(*)
FROM orders o
LEFT JOIN customers c   ON c.id = o.customer_id
LEFT JOIN products p    ON p.id = o.product_id
LEFT JOIN categories ca ON ca.id = p.category_id
WHERE o.ordered_at >= '2025-01-01' AND o.ordered_at < '2026-01-01';
実行計画は次のとおりです。
-> Aggregate: count(0)  (cost=114022 rows=1) (actual time=500..500 rows=1 loops=1)
    -> Nested loop left join  (cost=108477 rows=55447) (actual time=0.306..492 rows=249308 loops=1)
        -> Nested loop left join  (cost=89070 rows=55447) (actual time=0.305..380 rows=249308 loops=1)
            -> Nested loop left join  (cost=69664 rows=55447) (actual time=0.303..231 rows=249308 loops=1)
                -> Filter: ((o.ordered_at >= TIMESTAMP'2025-01-01 00:00:00') and (o.ordered_at < TIMESTAMP'2026-01-01 00:00:00'))  (cost=50257 rows=55447) (actual time=0.3..77.8 rows=249308 loops=1)
                    -> Table scan on o  (cost=50257 rows=499125) (actual time=0.299..49.8 rows=500000 loops=1)
                -> Single-row covering index lookup on c using PRIMARY (id=o.customer_id)  (cost=0.25 rows=1) (actual time=482e-6..503e-6 rows=1 loops=249308)
            -> Single-row index lookup on p using PRIMARY (id=o.product_id)  (cost=0.25 rows=1) (actual time=465e-6..487e-6 rows=1 loops=249308)
        -> Single-row covering index lookup on ca using PRIMARY (id=p.category_id)  (cost=0.25 rows=1) (actual time=322e-6..344e-6 rows=1 loops=249308)
全体で約 500 ミリ秒かかっています。orders を全件走査して50万行を読み、期間内の行数に絞り込んだあと、その1行ごとに customers、products、categories を引いています。件数を数えるだけなら、これらのテーブルの値は使っていません。
そこで、結合を外して orders だけで数えます。
SELECT COUNT(*)
FROM orders o
WHERE o.ordered_at >= '2025-01-01' AND o.ordered_at < '2026-01-01';
EXPLAIN ANALYZE の結果は次のとおりです。
-> Aggregate: count(0)  (cost=55802 rows=1) (actual time=77.8..77.8 rows=1 loops=1)
    -> Filter: ((o.ordered_at >= TIMESTAMP'2025-01-01 00:00:00') and (o.ordered_at < TIMESTAMP'2026-01-01 00:00:00'))  (cost=50257 rows=55447) (actual time=0.318..71.5 rows=249308 loops=1)
        -> Table scan on o  (cost=50257 rows=499125) (actual time=0.316..43.6 rows=500000 loops=1)
約 500 ミリ秒から約 78 ミリ秒になり、6倍ほど速くなりました。
今回は結合先をすべて主キーで LEFT JOIN しているため、結合を外しても件数は変わりません。一方で、結合の仕方や条件によっては、外すと件数が変わり得るため、外してよいかはクエリごとに確認が必要です。
このパターンは、実行計画の問題というより、クエリが本当に必要なものだけを取得しているかという問題でした。
改修を重ねたクエリではこういう不要な処理が残りやすいので注意が必要です。
N+1 クエリとは、一覧を取得するクエリを1回発行したあと、その結果の1件ごとに関連データを取得するクエリを発行してしまうことを指します。一覧が N 件であれば、合計で N+1 回のクエリが発行されます。知っている方も多いと思います。
たとえば、商品の一覧を取得したあと、ループの中で商品ごとに画像を取得すると、次のようなクエリが商品の件数分だけ発行されます。
SELECT url FROM product_images WHERE product_id = 1 AND kind = 'main';
SELECT url FROM product_images WHERE product_id = 2 AND kind = 'main';
SELECT url FROM product_images WHERE product_id = 3 AND kind = 'main';
-- 以下、商品の件数分続く
1回のクエリはインデックスが効いていて十分速いため、EXPLAIN ANALYZE でクエリを1つずつ見ても問題は見つかりません。一方で、クエリごとにアプリケーションと DB の間の通信が発生するため、件数が増えるほど全体の処理時間が伸びていきます。
対処としては、必要な ID をまとめて1回のクエリで取得し、アプリケーション側で商品 ID をキーにした Map などに詰めてから組み立てます。
SELECT product_id, url
FROM product_images
WHERE product_id IN (1, 2, 3 /* ... */) AND kind = 'main';
N+1 クエリは実行計画には現れないため、見つけるにはクエリの実行回数に注目する必要があります。クエリごとの実行回数や合計時間は、次の機能で確認できます。
MySQL では、 sys スキーマの statement_analysis ビューを使います。Performance Schema が有効である必要があります。
PostgreSQL では、pg_stat_statements 拡張を使います。postgresql.conf の shared_preload_libraries への追加と、CREATE EXTENSION による有効化が必要です。
想定より実行回数が多いクエリがあれば、N+1 を疑うとよいと思います。
参考:
インデックスは有効な改善手段ですが、作成するときに注意したい点もあります。
カーディナリティ(列に含まれる値の種類の多さ)が低い列や、特定の値に行が偏っている列では、検索する値によってはインデックスの効果が薄くなります。例えば、サンプル環境の orders.status が 0 から 4 の 5種類しか値がなく、4 が全体の約 96%(48 万行)、0 から 3 はそれぞれ約 1%(5,000 行)になるようにデータを偏らせてみます。この列にインデックスを作成し、まず少数派の status = 0 で絞り込んで件数を数えてみました。
CREATE INDEX idx_orders_status ON orders (status);

SELECT COUNT(*)
FROM orders
WHERE status = 0;
EXPLAIN ANALYZE の結果は次のとおりです。
-> Aggregate: count(0)  (cost=1004 rows=1) (actual time=0.508..0.508 rows=1 loops=1)
    -> Covering index lookup on orders using idx_orders_status (status=0)  (cost=504 rows=5000) (actual time=0.0225..0.386 rows=5000 loops=1)
約 0.5 ミリ秒で終わっています。IGNORE INDEX でインデックスを使わないように指定し、全件走査させた場合は約 60 ミリ秒だったので、100倍ほど速くなっています。
次に、多数派の status = 4 で、同じように件数を数えてみました。
SELECT COUNT(*)
FROM orders
WHERE status = 4;
EXPLAIN ANALYZE の結果は次のとおりです。
-> Aggregate: count(0)  (cost=50066 rows=1) (actual time=50.2..50.2 rows=1 loops=1)
    -> Covering index lookup on orders using idx_orders_status (status=4)  (cost=25109 rows=249562) (actual time=0.318..37.6 rows=480000 loops=1)
こちらもインデックスは使われていますが、約 50 ミリ秒かかっています。IGNORE INDEX で全件走査させた場合は約 79 ミリ秒だったので、そこまで顕著な差が出ていません。インデックスで絞り込める量がほとんどなく、効果が出にくかったと考えられます。
もう1つ考慮する点は、書き込みへの影響です。インデックスは INSERT・UPDATE・DELETE のたびに更新されるため、数が増えるほど書き込みのコストが上がります。
インデックスは闇雲に増やすのではなく、実際に遅いクエリの実行計画を確認し、効果がある箇所に絞って作成することが重要です。
この記事では、遅いクエリのよくあるパターンをサンプル環境で再現し、EXPLAIN ANALYZE で確認しながら改善してみました。
スケールアップを検討する前に、まず計測して実行計画を読んでみることも重要だと思います。遅いクエリの調査に取り組む方の参考になれば幸いです。