AWS re:Invent 2023 Day2 レポート
yassan
デロイト トーマツ ウェブサービス株式会社(DWS)公式ブログ
最近、Amazon S3 バケットの設計に携わる機会があり、特にアクセス制御まわりで学びがありました。S3 は多くのプロジェクトで使われるサービスであり、基本的な利用方法自体は比較的導入しやすい一方、プロジェクト要件を設計に落とし込む段階では、確認すべき前提が増えやすい印象があります。
本記事では S3 の機能の解説ではなく、設計時に悩んだポイントを整理します。あわせて、理想どおりの権限制御が難しかった時に選んだ補償制御についても触れたいと思います。
なお、本記事は特定案件の構成公開ではなく、設計時の観点整理です。
アクセス制御に関する要件は、おおむね次のとおりでした。
team-a/ のみアクセス可能とするteam-b/ のみアクセス可能とする要件のイメージは次のとおりです。
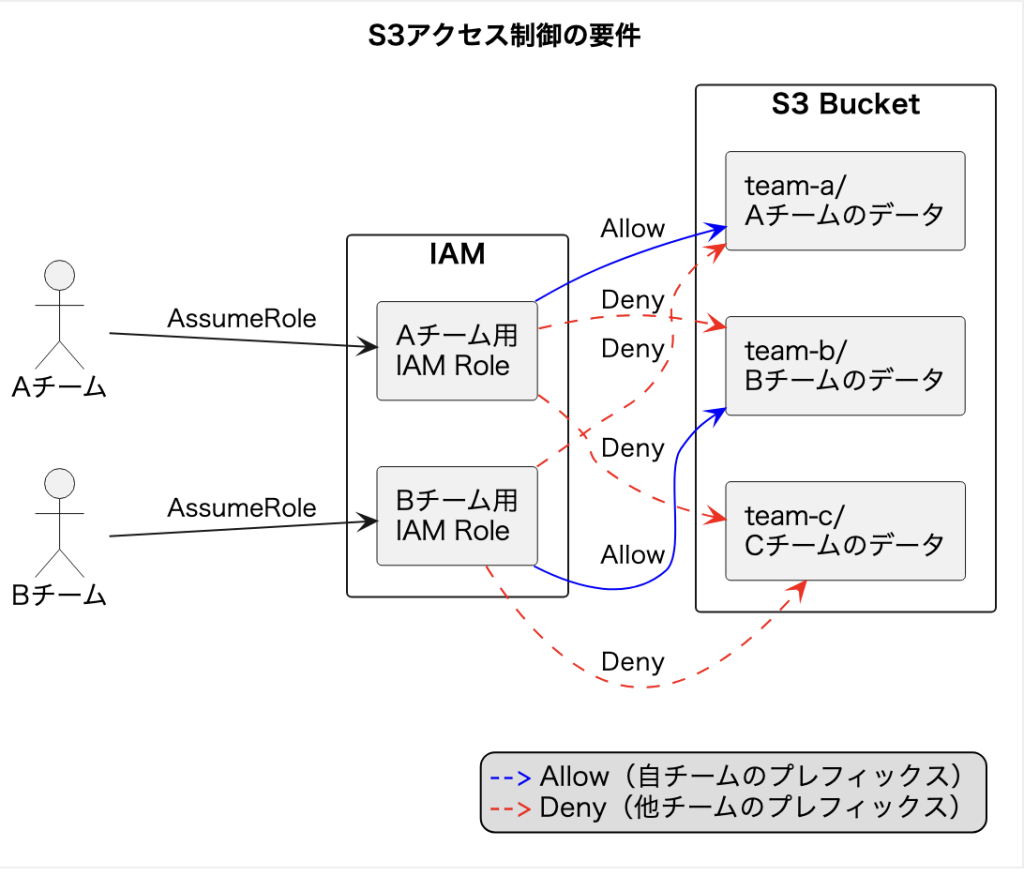
上記を「プレフィックス別にアクセスを分ける要件」と捉え、直感的には Bucket Policy でチームごとの許可・拒否を書けば進められそうだと考えていました。方針自体は単純に見えますが、実際にはその前提として確認・考慮すべき点が残っていました。
ここで改めて、「A チーム」「B チーム」が AWS 上では誰としてアクセスするのかを整理する必要がありました。
最初に確認したのは、S3 を利用するチームが 同一アカウント にいるのか、クロスアカウント なのかという点です。
アカウント境界が変わると、検討するポリシーの範囲も広がります。特にクロスアカウントの場合、S3 のアクセス許可だけで完結せず、暗号化に AWS KMS(SSE-KMS)を使うのであれば、KMS キー側の権限もあわせて考える必要があります。
SSE-KMS を利用する場合のイメージは次のとおりです。
結果として、「S3 のアクセス制御」に加えて、実際には暗号鍵の境界まで含む設計が必要でした。
プレフィックス単位でアクセスを分けたい一方で、両チームが 同じ IAM ロール を使っていると、次のような構造になります。
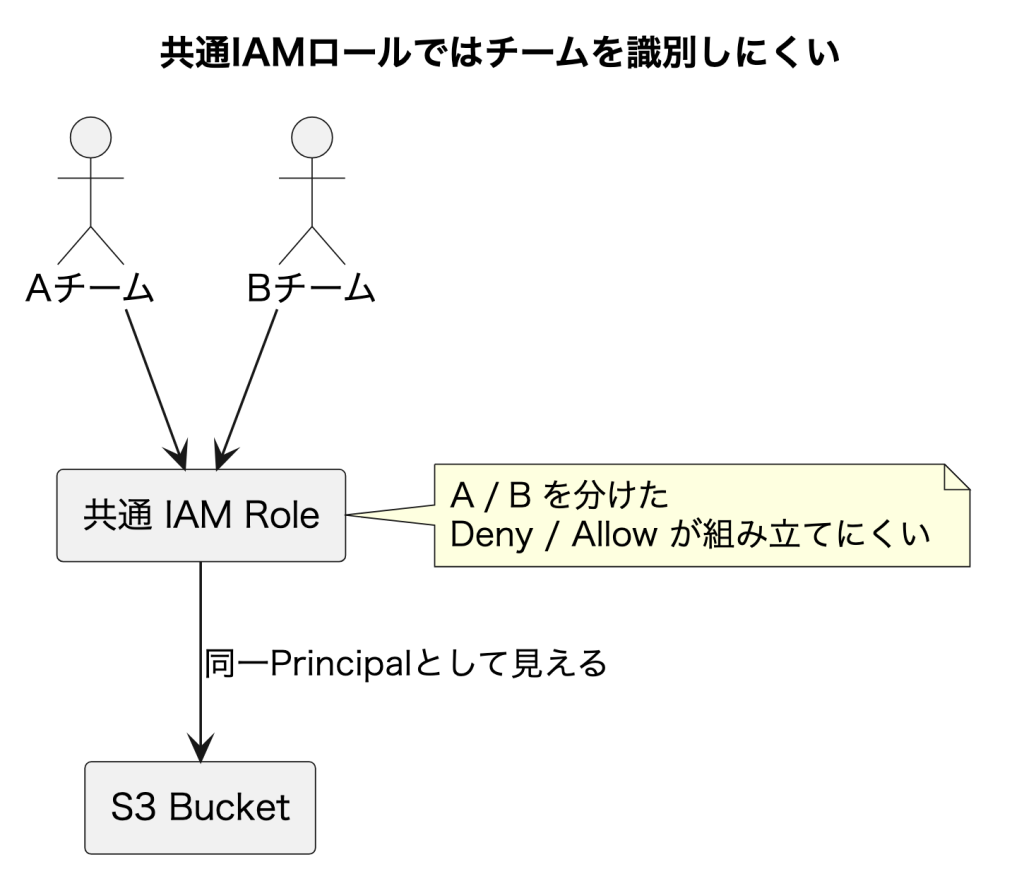
この場合、S3 から見ると A/B は同じ Principal に見えており、「A 以外を拒否」「B 以外を拒否」といった制御が意図どおり組み立てにくくなります。Bucket Policy の書き方だけでは足りず、IAM ロールの設計まで遡って考える必要がありました。
整理すると、次のとおりです。
ロールや権限セットを Principal 単位で分けて制御したい場合など、アクセス制御したい単位と、AWS 上で識別できるアクセス主体の単位は揃っている必要がある。
「誰を区別したいのか」を先に決め、その単位が Principal として表現できるかを確認する、という順番が必要でした。
ここまでの話を、設計の順番に落とすと次のとおりです。
どちら一方だけでは足りません。ロールが分かれていても Bucket Policy が粗いと他チームのデータに届いてしまいますし、Bucket Policy だけ細かくしても Principal が同じだと意図どおり区別できません。
加えて、同一アカウントかクロスアカウントか、SSE-KMS を使うかといった前提によって、アカウントや KMS キー側の権限もあわせて見る必要があります。S3 の設定だけを見て完結させない、という点がポイントでした。
今回の結論としては採用しませんでしたが、チーム増加を見据えると、1 つの Bucket Policy に制御を集約し続けるのがよいのかのついても検討材料になります。Access Points のようにアクセス経路を分ける選択肢も含め、「技術的に実現できるか」だけでなく 運用・管理しやすいか も考えるといいと思います。
要件に対して本来目指したかったのは、次のような境界設計です。
つまり、「誰が・どのプレフィックスに・どの単位でアクセスするか」を、認証主体の設計から揃えるのが本筋だと考えています。
一方で、アクセス主体をすべて理想どおりに分割できたわけではありません。今回の整理では、次のように分かれました。
| アクセスの種類 | 例 | 今回の扱い |
|---|---|---|
| ワークロード/サービスロール | EC2 インスタンスプロファイル、アプリケーション用 IAM ロールなど | Principal を識別できるため、Bucket Policy でプレフィックス単位の許可・拒否を追加できた |
| 人による操作 | IAM Identity Center(旧称 AWS SSO)の権限セット経由のアクセス | 今回の前提ではチーム単位での権限セット分割までが難しく、プレフィックス分離をロール側から完全には閉じられなかった |
つまり、サービスロール側はBucket Policyで適用でき、人側(SSO権限セット)の分割設計が追いつかなかった、 という位置づけです。
少なくとも Principal 単位でチームを分けて制御したい場合、人のアクセス主体がチーム単位で分かれていないと、S3 側だけできれいに「チーム A は team-a/ のみ」と閉じきるのは難しくなります。
これに対し、サービスロールで抑えられる範囲は抑えつつ、人のアクセスについて認可の境界を理想どおりに置けない前提で、残るリスクをどこで抑えるかを改めて設計する必要がありました。今回の整理では、後述する制御可能な範囲と補償制御で対応する範囲を分けました。
まず、識別できるアクセス主体については権限制御を進めました。
そのうえで、人(SSO 権限セット)側の分割が難しい残存リスクに対しては、完全なプレフィックス分離の代替ではなく以下の補償制御を採用しました。
| 目的 | 採用した仕組み | 狙い |
|---|---|---|
| 誤削除・上書きからの保護 | S3 Versioning + S3 Object Lock | 意図しない削除や上書きが起きても、オブジェクトを回復・保持しやすくする |
| アクセスの可視化 | CloudTrail のデータイベント | 誰がどのオブジェクトにアクセスしたかの履歴を残し、事後確認できるようにする |
今回採用したVersioning、Object Lock、CloudTrailデータイベントは、誤削除・上書き時の復旧可能性や監査性を高めるためのものです。人の操作まで含めて、チーム単位で「読めない/書けない」を厳密に閉じるものではありません。保持期間やコストも要件に応じて確認する必要があります。※1 バージョニングやオブジェクトロック、CloudTrail、権限セット設計の詳細は本記事の主題ではないため、ここでは方針の位置づけにとどめます。
※1: CloudTrailのS3データイベントはデフォルトでは有効になっていないため、対象バケットや対象プレフィックスを明示して有効化する必要があります。また、オブジェクトアクセスが多いバケットではログ量とコストが増えるため、記録対象、保持期間、分析方法をあわせて設計してください。
最初は「プレフィックスごとに Bucket Policy を書けばよい」と考えていました。実際には、アクセス主体をワークロードと人で分け、境界をセットで考える必要がありました。
サービスロールは Bucket Policy で制御できました。一方、今回の前提では人(IAM Identity Center の権限セット)のチーム単位分割までは難しかったため、Versioning・Object Lock と CloudTrail データイベントで残存リスクを抑える方針を選びました。
確認しておくとよい点を整理すると、次のとおりです。
同様の設計を検討する際の参考になれば幸いです。